A IA acha que você é preguiçoso
Uma IA (não, não foi o Pensador Profundo) olhou para a humanidade inteira, fez as contas e concluiu que somos preguiçosos.
Eu, que estou há +25 dias sem publicar nada aqui e tenho uma rotina automática programada só para me chamar de preguiçoso, achei a acusação precipitada. Digo, precisa demais.
Só que, lendo os números com calma (com muita calma, porque sou preguiçoso), a coisa ficou mais interessante. A IA não erra sobre mim. Ela erra sobre a sua avó - e não, não é zoeira de quinta série. Por que eu começaria um post zoando a sua vovozinha?
O boletim da humanidade
No dia 20 de outubro de 2026, a Rehearsals lançou o Human Behavior Bench , em parceria com o Google DeepMind e o Kaggle . A proposta é medir uma coisa que nenhum benchmark media: o quanto um modelo de IA entende gente de verdade.
Entrevistaram 1.244 adultos dos EUA, em 750 categorias, somando 95 mil respostas. Guardaram 80% disso a sete chaves, para ninguém treinar o modelo com a cola. Depois pediram para as IAs preverem como essas pessoas responderiam.
O melhor dos modelos de ponta, o Gemini 4 Argon, tirou 80,6 de 100. O resto do pelotão (GPT, Claude, Grok e companhia) ficou entre 76,2 e 79,5.
Nota de aluno que estudou na véspera. Passa, mas não convence.
(A métrica se chama Distribution Agreement e o comunicado não explica como ela é calculada, então a nota merece uma pitadinha de sal metafórico para fazer algum sentido.)
O próprio comunicado resume o diagnóstico numa frase: os modelos acham que a maioria das pessoas é menos atenta, universalmente mão-de-vaca e mais preguiçosa do que realmente é.
Tradução sem anestesia: a IA imagina o ser humano médio como um tiozão desligado, mão-de-vaca e de pijama (aqueles com bolso para cigarro) às três da tarde de domingo. Alguns exemplos do que ela acha versus o que acontece:
- Acha que a maioria das pessoas acima de 65 anos não vê vídeo curto. Na real, 80% viram na semana anterior;
- Acha que só metade das pessoas entre 55 e 64 anos manteria um plano depois de um aumento de 4 dólares. Na real, 70% mantêm;
- Acha que 30% dos pais de crianças pequenas cozinham. Na real, uns 66%; e
- Acha que 5% dos compradores mais velhos do meio-oeste americano pagam por aproximação com o celular. Na real, 25%. (O meio-oeste evoluiu e ninguém mandou o memorando.)
Qualquer brasileiro com um grupo da família no WhatsApp sabe que o vovô não só vê vídeo curto como encaminha quarenta por dia, com legenda em caps lock. Ainda mais se forem vídeos de novelinha de frutas.
A IA, que leu a internet inteira, não sabia.
De onde vem tanto preconceito?
Aqui eu saio dos dados e entro no boteco, então leia como hipótese de quem já pediu a terceira dose de Xiboquinha.
Os modelos aprenderam sobre a humanidade lendo o que a humanidade escreve sobre si mesma. E a internet é um grande confessionário de autodepreciação (seria este site a prova viva disso?).
“Hoje não fiz nada.” “Procrastinei o dia inteiro.” “Segunda-feira, né.” Ninguém posta “cozinhei o jantar, paguei o boleto em dia e fui dormir cedo”. Comportamento normal não engaja.
Aí o modelo lê um bilhão de reclamações e conclui, com toda a lógica do mundo, que a espécie inteira é o Hardy, aquela hiena da Hanna-Barbera que tem distimia. Oh dia, oh céus, oh azar.
O segundo suspeito é velho conhecido. Daniel Kahneman, em Rápido e Devagar (2011), descreve a heurística da representatividade: a gente julga a probabilidade de algo pelo quanto aquilo se parece com um estereótipo, e ignora o resto.
O exemplo clássico é a Linda, de Tversky e Kahneman (1983). Uma moça engajada, formada em filosofia, preocupada com justiça social. A maioria das pessoas acha mais provável ela ser “caixa de banco e feminista” do que só “caixa de banco”. O que é matematicamente impossível (a parte nunca é mais provável do que o todo), mas soa tão certo.
Um modelo de linguagem é o Sistema 1 do Kahneman em escala industrial. Fluente, confiante e apaixonado por estereótipos bem acabados. “Idoso” combina com “não entende de tecnologia”. Pronto, previsão feita.
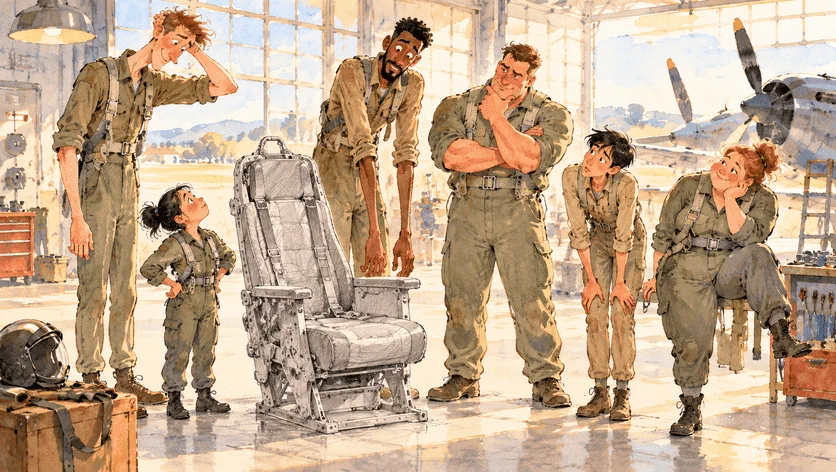
O terceiro suspeito é o humano médio. Todd Rose conta em The End of Average (2016) que, em 1950, a Força Aérea americana mediu 4.063 pilotos em dez dimensões do corpo para projetar a cabine ideal. Quantos estavam na média nas dez?
Nenhum.
A cabine feita para o piloto médio não servia para piloto nenhum. E um modelo que trabalha com o retrato médio vai errar justamente nos recortes que fogem do estereótipo, tipo os mais velhos e os pais de criança pequena. Que, por coincidência, são bastante gente.
Os modelos se parecem mais entre si do que com a gente
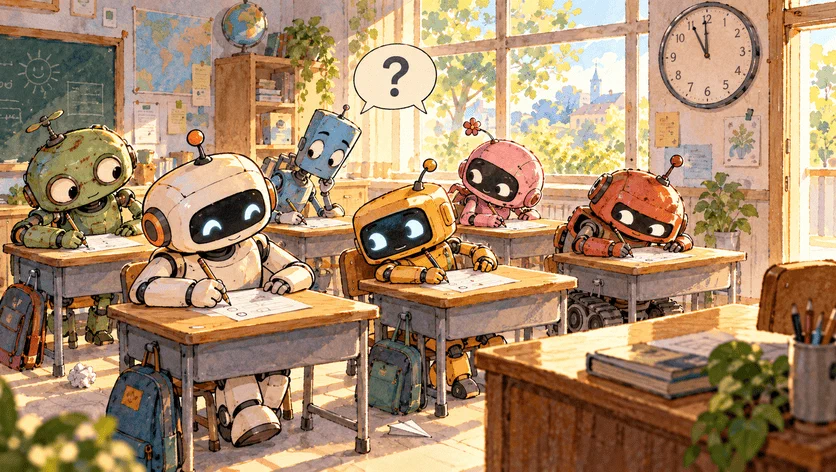
Olha de novo o placar. Seis modelos de ponta, de quatro empresas diferentes, com orçamentos, filosofias e CEOs diferentes, todos espremidos numa faixa de uns quatro pontos.
Parece aquela turma em que seis alunos colaram da mesma prova errada. Ninguém combinou nada, mas todo mundo leu a mesma internet.
Isso me incomoda mais do que a nota. Se todo mundo usa modelos parecidos para prever o cliente, todo mundo aposta errado do mesmo jeito, ao mesmo tempo. O Taleb passou a carreira avisando que o risco de verdade mora naquilo que todo mundo concorda ser seguro.
Monocultura de opinião, agora powered by um montão de GPU.
Personas sintéticas e o marketing de pijama
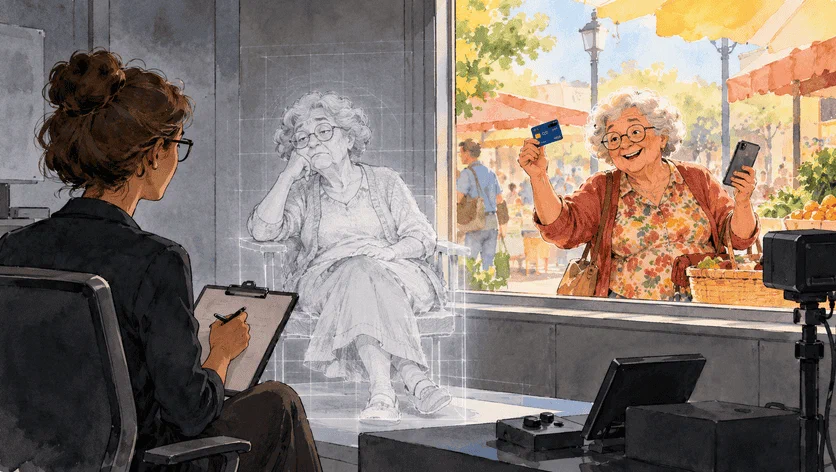
Existe um mercado de “personas sintéticas”. Em vez de perguntar para a Dona Maria, 67 anos, o que ela acha do seu produto, você pergunta para uma IA fingindo ser a Dona Maria. Mais barato, mais rápido e a Dona Maria sintética nunca reclama do café da sala de pesquisa.
O problema é que vários dos subgrupos em que a IA errou são gente que compra. O cinquentão e o sessentão que mantêm o plano depois do reajuste. Quem tem criança pequena em casa, cozinha todo dia e decide o que entra no carrinho da Amazon.
Se a sua persona sintética jura que a vovó não vê vídeo curto, você não anuncia lá. E o concorrente que perguntou para uma vovó de carne e osso come o seu almoço. Com a vovó junto. Sem duplo sentido, por favor.
Agora, a parte que eu acho mais divertida. Quem criou o benchmark? A Rehearsals, em parceria com o Google DeepMind. E a Rehearsals é uma empresa que vende… gêmeos de IA de pessoas reais, para testar preço e campanha “em 30 minutos”.
E quem ficou em primeiro lugar no ranking, com 94,1? O modelo da própria Rehearsals, o Engram 1.0.
Conveniente, não?
Para ser justo, o comunicado diz que o Engram não foi treinado com o conteúdo do benchmark e que a maior parte dos dados é privada. Pode ser tudo verdade, embora treino e prova tenham saído da mesma plataforma de pesquisa. Mas é o aluno que ajudou a escrever a prova e tirou 9,4. (Não é acusação de nada, juro!)
E vale lembrar que é a primeira versão, só com americanos. A próxima promete mais quatro países. Se o Brasil entrar, aposto que a IA vai prever que todo mundo acima de 60 manda “bom dia” com foto de flor no grupo da família.
E, pela primeira vez, vai acertar.
Então, somos ou não somos preguiçosos?
Pelos dados, não. Pelo menos os americanos entrevistados são mais atentos, mais dispostos a pagar e mais ativos do que a IA imagina.
Só que a IA não inventou essa imagem do nada. Provavelmente ela aprendeu com o retrato que a gente mesmo pinta, todo dia, reclamando em público de uma preguiça que, no fim das contas, nem é tão grande assim. O humano médio trabalha mais do que os próprios tweets.
Isso deixa duas lições meio práticas: antes de confiar no retrato que um modelo faz do seu cliente, pergunte para um cliente. E, se quiser que a próxima geração de IA tenha uma opinião melhor sobre a gente, talvez valha postar de vez em quando que você fez alguma coisa.
(Vou fingir que esses +25 dias sem post foram pesquisa de campo.)
Referências
KAHNEMAN, Daniel. Thinking, fast and slow. New York: Farrar, Straus and Giroux, 2011.
REHEARSALS. Rehearsals launches Human Behavior Bench with Google DeepMind and Kaggle to measure how well AI models understand humanity. New York: EZ Newswire, 20 out. 2026. Disponível em: https://www.eznewswire.com/newsroom/rehearsals-launches-human-behavior-bench-google-deepmind . Acesso em: 21 out. 2026.
ROSE, Todd. The end of average: how we succeed in a world that values sameness. New York: HarperOne, 2016.
TVERSKY, Amos; KAHNEMAN, Daniel. Extensional versus intuitive reasoning: the conjunction fallacy in probability judgment. Psychological Review, v. 90, n. 4, p. 293-315, 1983. DOI: 10.1037/0033-295X.90.4.293.