La IA cree que eres perezoso
Una IA (no, no fue el Pensador Profundo) miró a toda la humanidad, hizo las cuentas y concluyó que somos perezosos.
Yo, que llevo más de 25 días sin publicar nada aquí y tengo una rutina automática programada solo para llamarme perezoso, encontré la acusación precipitada. Digo, exagera mucho.
Pero, leyendo los números con calma (con mucha calma, porque soy perezoso), la cosa se volvió más interesante. La IA no se equivoca sobre mí. Se equivoca sobre tu abuela —y no, no es broma de quinto grado. ¿Por qué empezaría un post burlándome de tu abuelita?
El boletín de la humanidad
El 20 de octubre de 2026, Rehearsals lanzó el Human Behavior Bench , en asociación con Google DeepMind y Kaggle . La propuesta es medir algo que ningún benchmark medía: cuánto entiende un modelo de IA a la gente de verdad.
Entrevistaron a 1.244 adultos de EE. UU., en 750 categorías, sumando 95.000 respuestas. Guardaron el 80% de eso bajo llave, para que nadie entrenara el modelo con la chuleta. Después pidieron a las IAs que predijeran cómo responderían esas personas.
El mejor de los modelos de punta, el Gemini 4 Argon, sacó 80,6 de 100. El resto del pelotón (GPT, Claude, Grok y compañía) quedó entre 76,2 y 79,5.
Nota de alumno que estudió en la víspera. Pasa, pero no convence.
(La métrica se llama Distribution Agreement y el comunicado no explica cómo se calcula, así que la nota merece una pizca de sal metafórica para que tenga algo de sentido.)
El propio comunicado resume el diagnóstico en una frase: los modelos creen que la mayoría de la gente es menos atenta, universalmente tacaña y más perezosa de lo que realmente es.
Traducción sin anestesia: la IA imagina al humano medio como un tío despistado, tacaño y en pijama (esos con bolsillo para el cigarrillo) a las tres de la tarde un domingo. Algunos ejemplos de lo que cree la IA frente a lo que pasa realmente:
- Cree que la mayoría de las personas mayores de 65 años no ven vídeo corto. En realidad, el 80% vio uno la semana anterior;
- Cree que solo la mitad de las personas entre 55 y 64 años mantendría un plan tras un aumento de 4 dólares. En realidad, el 70% lo mantiene;
- Cree que el 30% de los padres con niños pequeños cocina. En realidad, unos 66%; y
- Cree que el 5% de los compradores mayores del Medio Oeste americano pagan por aproximación con el móvil. En realidad, el 25% lo hace. (El Medio Oeste evolucionó y nadie mandó el memorándum.)
Cualquier brasileño con un grupo familiar en WhatsApp sabe que el abuelo no solo ve vídeos cortos sino que reenvía cuarenta al día, con subtítulo en mayúsculas. Más aún si son vídeos de novelas de frutas.
La IA, que leyó internet entera, no lo sabía.
¿De dónde viene tanto prejuicio?
Aquí salgo de los datos y entro al bar, así que léelo como hipótesis de quien ya pidió la tercera ronda de Xiboquinha.
Los modelos aprendieron sobre la humanidad leyendo lo que la humanidad escribe sobre sí misma. Y la internet es un gran confesionario de autodepreciación (¿será este sitio la prueba viva de eso?).
“Hoy no hice nada.” “Procrastiné todo el día.” “Lunes, ¿no?” Nadie publica “cociné la cena, pagué la factura a tiempo y me fui a dormir temprano”. El comportamiento normal no engancha.
Entonces el modelo lee mil millones de quejas y concluye, con toda la lógica del mundo, que la especie entera es el Hardy, esa hiena de Hanna-Barbera que tiene distimia. Oh día, oh cielos, oh mala suerte.
El segundo sospechoso es viejo conocido. Daniel Kahneman, en Thinking, Fast and Slow (2011), describe la heurística de la representatividad: juzgamos la probabilidad de algo por cuánto se parece a un estereotipo, e ignoramos el resto.
El ejemplo clásico es Linda, de Tversky y Kahneman (1983). Una mujer comprometida, con estudios de filosofía, preocupada por la justicia social. La mayoría piensa que es más probable que sea “cajera y feminista” que solo “cajera”. Lo cual es matemáticamente imposible (la parte nunca es más probable que el todo), pero suena tan convincente.
Un modelo de lenguaje es el Sistema 1 de Kahneman a escala industrial. Fluido, seguro de sí mismo y apasionado por los estereotipos bien acabados. “Anciano” encaja con “no entiende de tecnología”. Listo, predicción hecha.
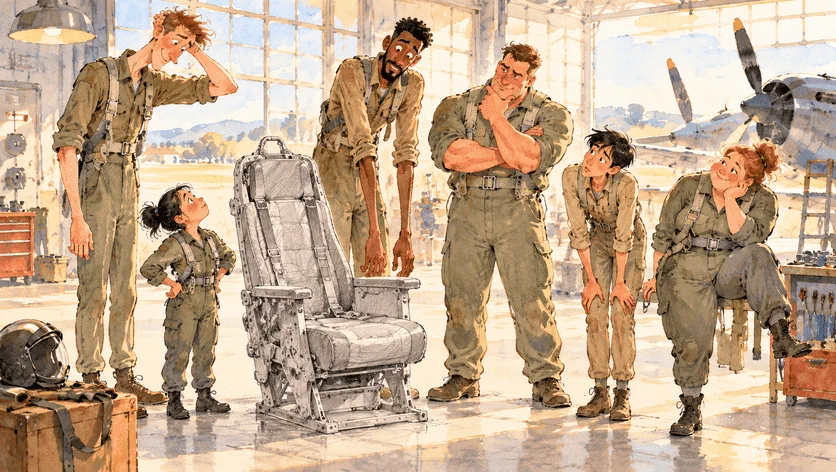
El tercer sospechoso es el humano medio. Todd Rose cuenta en The End of Average (2016) que, en 1950, la Fuerza Aérea americana midió a 4.063 pilotos en diez dimensiones corporales para diseñar la cabina ideal. ¿Cuántos estaban en la media en las diez?
Ninguno.
La cabina hecha para el piloto medio no servía para ningún piloto. Y un modelo que trabaja con el retrato medio va a fallar justamente en los cortes que se salen del estereotipo, como los mayores y los padres de niños pequeños. Que, por coincidencia, son bastante gente.
Los modelos se parecen más entre sí que a nosotros
Mira otra vez el marcador. Seis modelos de punta, de cuatro empresas distintas, con presupuestos, filosofías y CEOs diferentes, todos apretados en una franja de unos cuatro puntos.
Parece ese grupo en el que seis alumnos copiaron del mismo examen equivocado. Nadie se puso de acuerdo, pero todos leyeron la misma internet.
Eso me inquieta más que la nota. Si todo el mundo usa modelos parecidos para predecir al cliente, todos apuestan mal de la misma forma, al mismo tiempo. Taleb pasó la carrera avisando que el riesgo de verdad vive en lo que todos coinciden en que es seguro.
Monocultura de opinión, ahora potenciada por un montón de GPU.
Personas sintéticas y el marketing del pijama
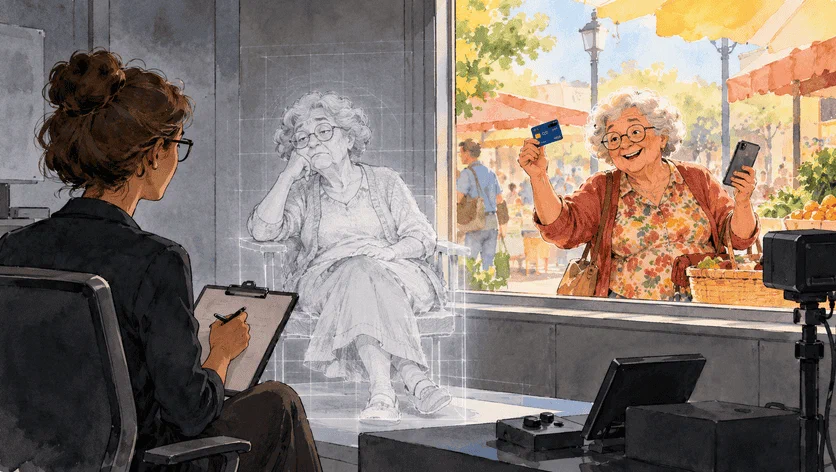
Existe un mercado de “personas sintéticas”. En lugar de preguntar a la Doña María, 67 años, qué piensa de tu producto, preguntas a una IA que finge ser la Doña María. Más barato, más rápido y la Doña María sintética nunca se queja del café de la sala de investigación.
El problema es que varios de los subgrupos en los que la IA falló son gente que compra. El cincuentón y el sesentón que mantienen el plan después del reajuste. Quienes tienen niños pequeños en casa, cocinan todos los días y deciden lo que entra en el carrito de Amazon.
Si tu persona sintética jura que la abuelita no ve vídeos cortos, no anuncias ahí. Y el competidor que preguntó a una abuela de carne y hueso se come tu almuerzo. Con la abuela incluida. Sin doble sentido, por favor.
Ahora, la parte que me parece más divertida. ¿Quién creó el benchmark? Rehearsals, en asociación con Google DeepMind. Y Rehearsals es una empresa que vende… gemelos de IA de personas reales, para probar precio y campaña “en 30 minutos”.
¿Y quién quedó en primer lugar en el ranking, con 94,1? El modelo de la propia Rehearsals, el Engram 1.0.
Conveniente, ¿no?
Para ser justo, el comunicado dice que Engram no fue entrenado con el contenido del benchmark y que la mayor parte de los datos es privada. Puede ser todo verdad, aunque entrenamiento y examen salieron de la misma plataforma de investigación. Pero es el alumno que ayudó a escribir la prueba y sacó 9,4. (No es acusación de nada, ¡lo juro!)
Y vale recordar que es la primera versión, solo con estadounidenses. La próxima promete cuatro países más. Si entra Brasil, apuesto a que la IA preverá que todo el mundo mayor de 60 manda “buen día” con foto de flor en el grupo familiar.
Y, por primera vez, acertará.
¿Entonces, somos o no somos perezosos?
Según los datos, no. Al menos los estadounidenses entrevistados son más atentos, más dispuestos a pagar y más activos de lo que la IA imagina.
Pero la IA no inventó esa imagen de la nada. Probablemente la aprendió del retrato que nosotros mismos pintamos, cada día, quejándonos en público de una pereza que, al final, ni es tan grande. El humano medio trabaja más que sus propios tuits.
Eso deja dos lecciones algo prácticas: antes de fiarte del retrato que un modelo hace de tu cliente, pregúntale a un cliente. Y, si quieres que la próxima generación de IA tenga una mejor opinión sobre nosotros, quizá valga la pena publicar de vez en cuando que hiciste algo.
(Fingiré que estos más de 25 días sin post fueron investigación de campo.)
Referencias
KAHNEMAN, Daniel. Thinking, fast and slow. New York: Farrar, Straus and Giroux, 2011.
REHEARSALS. Rehearsals launches Human Behavior Bench with Google DeepMind and Kaggle to measure how well AI models understand humanity. New York: EZ Newswire, 20 out. 2026. Disponível em: https://www.eznewswire.com/newsroom/rehearsals-launches-human-behavior-bench-google-deepmind . Acesso em: 21 out. 2026.
ROSE, Todd. The end of average: how we succeed in a world that values sameness. New York: HarperOne, 2016.
TVERSKY, Amos; KAHNEMAN, Daniel. Extensional versus intuitive reasoning: the conjunction fallacy in probability judgment. Psychological Review, v. 90, n. 4, p. 293-315, 1983. DOI: 10.1037/0033-295X.90.4.293.