Explicando LLM para a sua vovozinha
Sua vovozinha provavelmente já conversou com uma LLM. Pediu uma receita de bolo pro ChatGPT, perguntou pro assistente do celular se ia chover, e saiu de lá achando que falou com uma pessoinha minúscula presa dentro do aparelho - ou com o capiroto, depende da avó.
E a parte engraçada é que a maioria das pessoas que usam essas ferramentas todo dia não está muito mais informada que a vovó. Sabem que funciona. Não fazem ideia de como. É só uma caixa-preta que cospe texto.
Bora abrir a caixa. Sem aquela matemática que faz o cérebro derreter, e com analogias que cabem num almoço de domingo. Se no fim você conseguir explicar isso pra sua avó sem ela fazer o sinal da cruz, missão cumprida.
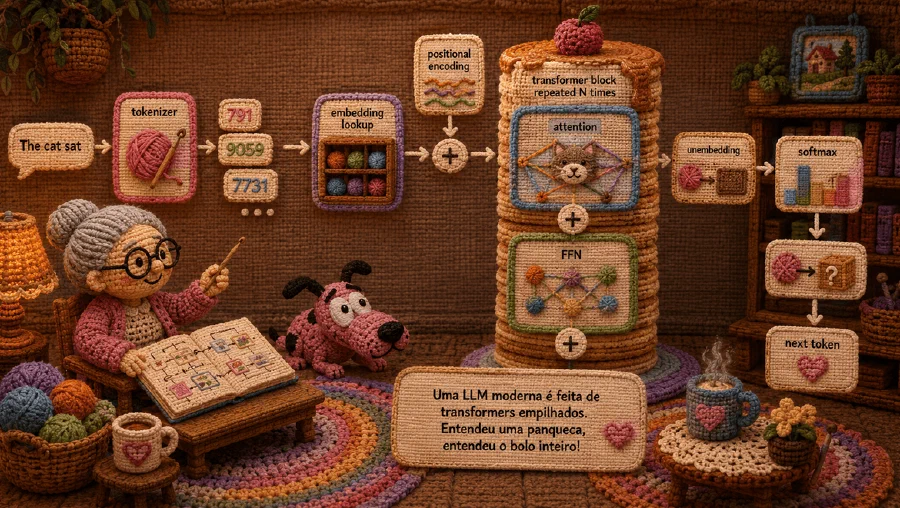
Quase tudo que você vai ler aqui se resume a uma coisa: as LLMs modernas são, na prática, blocos chamados transformers empilhados um em cima do outro feito panqueca. Entendeu uma panqueca, entendeu o bolo inteiro.
Tokens: a vovó não lê palavra inteira
Primeira verdade desconfortável: o modelo não lê texto. Ele lê números inteiros.
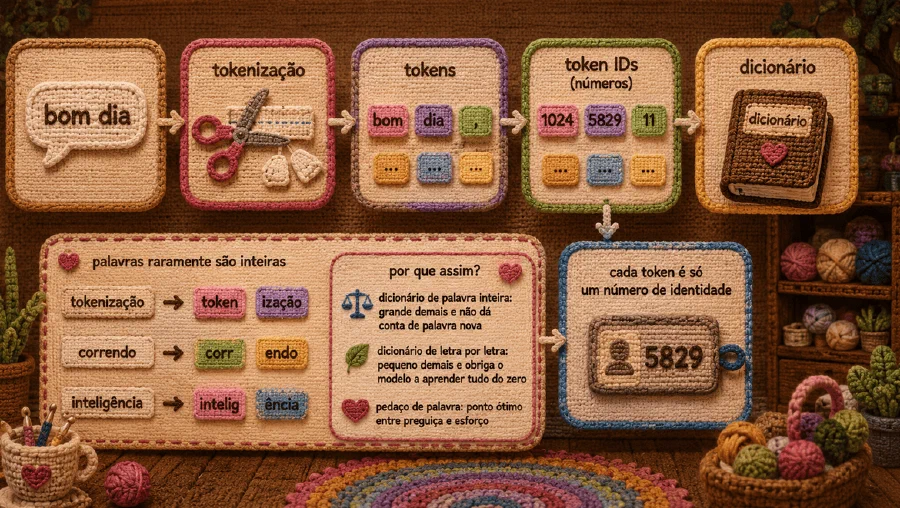
Quando você manda “bom dia”, uma etapa chamada tokenização pega essa string e quebra em pedacinhos, cada pedacinho vira um número (um token ID) que aponta pra uma entrada num dicionário fixo. Esse dicionário costuma ter de dezenas de milhares a algumas centenas de milhares de pedaços.
Glossário da vovó - token: é o pedacinho de texto que o modelo enxerga. E pra ele, esse pedacinho é só um número de identidade, não a palavra escrita.
O detalhe sacana é que os tokens raramente são palavras inteiras. Geralmente são pedaços de palavra. “Tokenização” pode virar [“token”, “ização”]. “Correndo” pode virar [“corr”, “endo”]. É a vovó cortando o pão: parte em fatias do tamanho que dá pra mastigar.
Por que assim? Porque dicionário de palavra inteira é grande demais e não dá conta de palavra nova. Dicionário de letra por letra é pequeno demais e obriga o modelo a aprender tudo do zero. O pedaço de palavra fica no meio-termo, o ponto ótimo entre preguiça e esforço, que é onde todos nós gostaríamos de morar.
E aqui mora o motivo de um truque que viralizou: pergunte pra uma LLM quantos R tem em “arroz”. Por muito tempo elas erravam feio. Não é que o modelo seja burro em contar - é que ele nunca viu as letras a-r-r-o-z. Ele viu o token “arroz” como um bloco só. Pedir pra ele contar as letras é como pedir pra você contar quantos grãos tem no prato sem deixar você olhar pra dentro da panela.
Agora a gente tem uma fileira de números. Mas número sozinho não significa nada. Precisamos dar sentido a eles.
Embeddings: o mapa mental da vovó
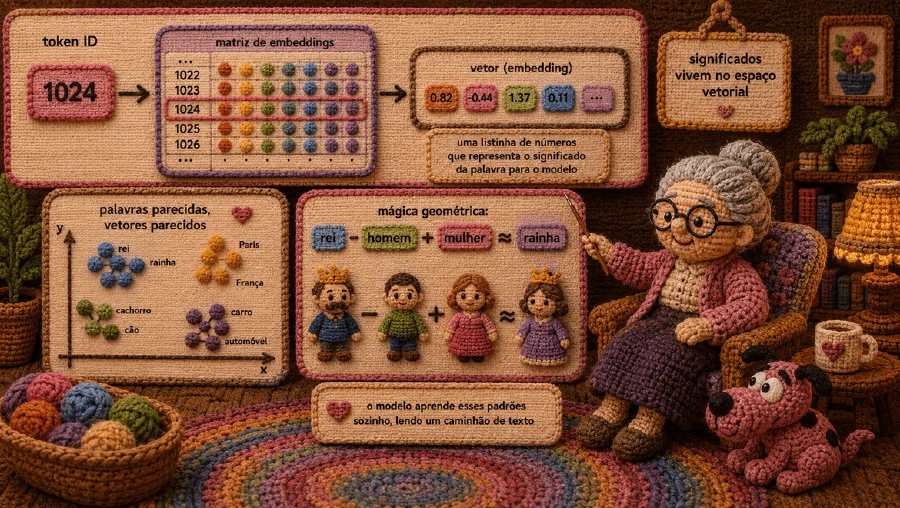
Um token ID tipo 1024 é só um índice. É o número da casa, não a casa. Quem dá significado é uma tabela gigante chamada matriz de embeddings.
Funciona assim: cada palavra do dicionário tem uma linha nessa tabela, e cada linha é uma lista comprida de números - um vetor. Quando o tokenizador entrega o número, o modelo vai lá e troca pelo vetor correspondente. Esse vetor é o que o modelo entende como o “significado” daquela palavra, e ele aprendeu isso sozinho, lendo um caminhão de texto.
Glossário da vovó - vetor: uma listinha de números. No transformer, cada palavra vira uma listinha dessas pra que o modelo possa fazer continha com ela.
O que torna isso interessante é que palavras parecidas acabam com vetores parecidos. “Rei” fica pertinho de “rainha”. “Paris” fica coladinho de “França”. Ninguém programou isso na mão - emerge sozinho do treino, porque ficar perto ajuda o modelo a acertar o texto.
É o mapa mental da sua avó. No cérebro dela, “novela” está colado em “Globo”, que está colado em “fofoca”, que está a dois quarteirões de “vizinha intrometida que fica com a cadeira na calçada o dia inteiro”. Ela nunca desenhou esse mapa. Foi se formando com os anos.
E tem uma mágica geométrica que dá até medo: dá pra fazer conta com os vetores. O exemplo clássico é rei - homem + mulher ≈ rainha. Tente fazer essa subtração no cérebro da sua avó e ela vai te perguntar se você anda comendo direito.
Só que tem um buraco aqui. O vetor de “cachorro” é o mesmo vetor sendo “cachorro” a primeira palavra da frase ou a quinta. O significado está lá, mas a ordem sumiu. E ordem importa.
Posição e Attention: quem mordeu quem no almoço de domingo
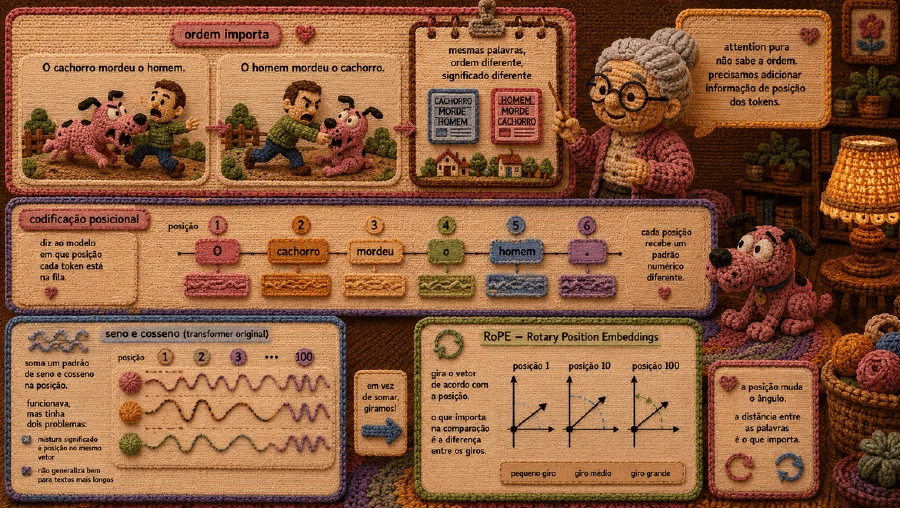
“O cachorro mordeu o homem” e “O homem mordeu o cachorro” usam exatamente as mesmas palavras. Só a ordem muda. E muda tudo - inclusive a manchete do jornal e o nível de preocupação do bairro.
A attention pura (já chego nela) não tem noção de ordem embutida. Então o modelo precisa de uma peça extra que injete a posição de cada token na conta. Isso é a codificação posicional.
Glossário da vovó - codificação posicional: é como o modelo descobre a ordem das palavras. Diz pra ele em que lugar da fila cada token está sentado.
O paper original do transformer (VASWANI et al., 2017) fazia isso somando um padrãozinho de números na posição de cada palavra - posição 1 tinha um padrão, posição 100 tinha outro, tudo baseado em ondas de seno e cosseno. Funcionava, mas tinha dois problemas chatos: o vetor precisava carregar significado e posição no mesmo balaio, e o esquema não generalizava bem pra textos mais longos do que ele tinha visto treinando.
Os modelos modernos (LLaMA, Mistral, Gemma, Qwen e quase toda a turma) usam um esquema diferente chamado RoPE - Rotary Position Embeddings (SU et al., 2021). Em vez de somar a posição, ele gira os vetores. Palavra na posição 1 leva um giro pequeno, palavra na posição 100 leva um giro maior. Quando duas palavras forem comparadas depois, o que importa é a diferença entre os giros - ou seja, o quão longe uma está da outra.
Glossário da vovó - RoPE: em vez de colar uma etiqueta de posição em cada palavra, ele gira as palavras. A diferença entre os giros conta a distância entre elas.
E olha que curioso: mesmo com posicionamento bom, as LLMs têm um problema documentado de “se perder no meio” (LIU et al., 2023). Elas usam melhor a informação no começo e no fim de um texto longo do que a do meio. É a sua avó contando uma história: ela lembra de como começou, lembra do final dramático, mas o que aconteceu no meio vira “ah, e aí teve umas coisas”. É por isso que aquela dica de prompt - “coloque o importante no começo ou repita no fim” - funciona de verdade.
Chegamos na peça que deu nome à coisa toda. Attention. Atenção.
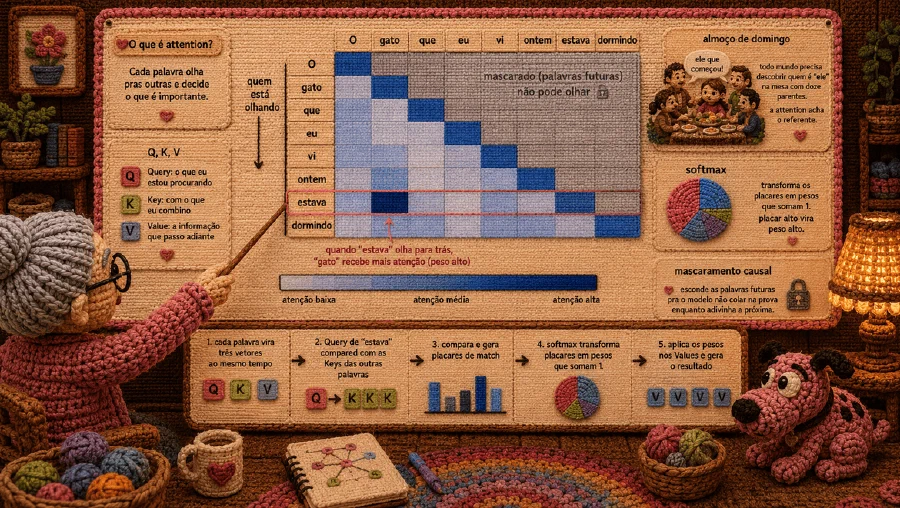
Dentro de cada camada, a attention faz uma coisa só: deixa cada palavra olhar pras outras palavras que ela tem permissão de ver e decidir quais importam.
Pra isso, cada palavra ganha três papéis ao mesmo tempo, transformando-se em três vetores: Query, Key e Value (Q, K, V).
Glossário da vovó - Q, K, V: Query é “o que eu estou procurando”, Key é “com o que eu combino” e Value é “a informação que vai ser copiada quando o combinado bate forte”.
A palavra “Query” pergunta: “o que eu procuro nas outras?”. A “Key” responde: “isso é o que eu ofereço pra quem me olhar”. E a “Value” carrega: “isso é o que passa adiante quando dá match”. A mesma palavra faz os três papéis simultaneamente, igual sua tia que no almoço pergunta, responde e ainda passa o recado pra cozinha.
Pega a frase “O gato que eu vi ontem estava dormindo”. Quando o modelo processa “estava”, ele precisa descobrir o que estava dormindo. A Query de “estava” é comparada com as Keys das outras palavras. O match com “gato” é alto (verbo precisa de sujeito), o match com “ontem” é baixo. Aí entra o softmax, que transforma esses placares em pesos que somam 1, e “gato” leva o peso gordo.
Glossário da vovó - softmax: transforma placares crus em pesos que somam 1. Placar alto vira peso alto, placar baixo vira peso baixo. É a vovó decidindo quem ela ouve na mesa.
É literalmente como o almoço de família onde alguém solta “ele que começou” e todo mundo precisa descobrir quem é “ele” numa mesa com doze parentes. A attention é o tio que olha pra trás na conversa, acha o referente e resolve a treta depois de fazer piada do pavê.
Tem uma regra específica dos modelos estilo GPT: eles geram texto da esquerda pra direita, então uma palavra na posição 5 só pode olhar pras posições 1 a 5. Não pode espiar as 6, 7, 8 - elas ainda não existem. Isso se chama mascaramento causal. Sua avó não pode comentar a fofoca que ainda não aconteceu (por mais que ela queira).
Glossário da vovó - mascaramento causal: esconde as palavras futuras pro modelo não colar na prova enquanto adivinha a próxima.
Um achado fascinante de pesquisa: existem cabeças de attention especializadas chamadas induction heads, descobertas por uma equipe da Anthropic (OLSSON et al., 2022). Elas aprendem a notar padrões do tipo “A B … A” e prever que vem “B” de novo. É um dos mecanismos mais claros por trás do in-context learning - a capacidade da LLM de pegar um padrão do seu prompt e continuar.
A conta da attention tem um custo feio: cada palavra se compara com todas as outras, então dobrar o tamanho do texto quase quadruplica o trabalho. Por isso prompt gigante sai caro e tem um monte de gente pesquisando como deixar isso mais leve.
Multi-head: a vovó assistindo três novelas ao mesmo tempo
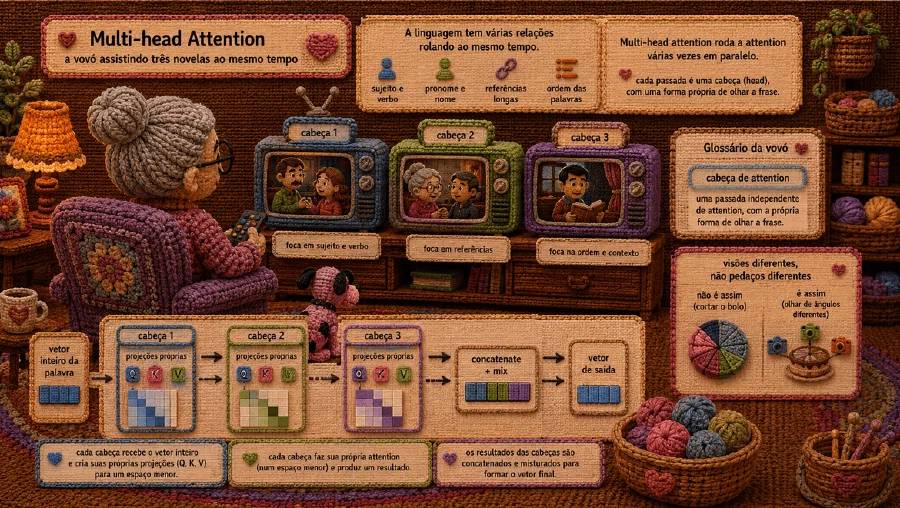
Uma passada só de attention dá uma única visão de quais palavras importam. Não basta. A linguagem tem várias relações rolando ao mesmo tempo: sujeito e verbo, pronome e nome, referências entre frases distantes, ordem das palavras.
A multi-head attention resolve rodando a attention várias vezes em paralelo, cada passada num espaço menor. Cada passada dessas é uma cabeça (head).
Glossário da vovó - cabeça de attention: uma passada independente de attention, com a própria forma de olhar a frase.
E aqui tem um detalhe que metade dos tutoriais explica errado: cada cabeça não recebe um pedaço fatiado do vetor original. Cada uma tem suas próprias matrizes que projetam o vetor inteiro num espaço menor. São visões diferentes da mesma palavra, não pedaços diferentes dela. É a diferença entre cortar o bolo em fatias e tirar oito fotos do bolo inteiro de ângulos diferentes.
É a vovó acompanhando três novelas, um futebol e uma fofoca de WhatsApp ao mesmo tempo - cada “cabeça” dela rastreia uma trama: essa daqui só presta atenção em quem está traindo quem, aquela só no filho perdido, a outra na herança. Ninguém mandou ela se especializar assim. Aconteceu com os anos.
O modelo também não é avisado do que cada cabeça deve fazer. A especialização emerge no treino. Pesquisadores acharam cabeças que rastreiam gramática, cabeças que ligam pronome a nome, cabeças de posição, as tais induction heads. Uma camada pode ter 32 cabeças. Um modelo de ponta tem dezenas de camadas. Resultado: milhares de cabeças, cada uma com sua manha.
Tem um custo aqui também. Cada cabeça precisa guardar suas Keys e Values na memória pra não recalcular tudo a cada palavra nova - isso é o KV cache, o principal gasto de memória de rodar uma LLM em texto longo. Pra economizar, os modelos modernos usam uma variação chamada GQA (Grouped-Query Attention), onde grupos de cabeças dividem as mesmas Keys e Values. O LLaMA-2 70B tem 64 cabeças de Query mas só 8 de Key/Value. Quase a mesma precisão, bem menos peso.
Feed-forward: o armário de remédios da vovó
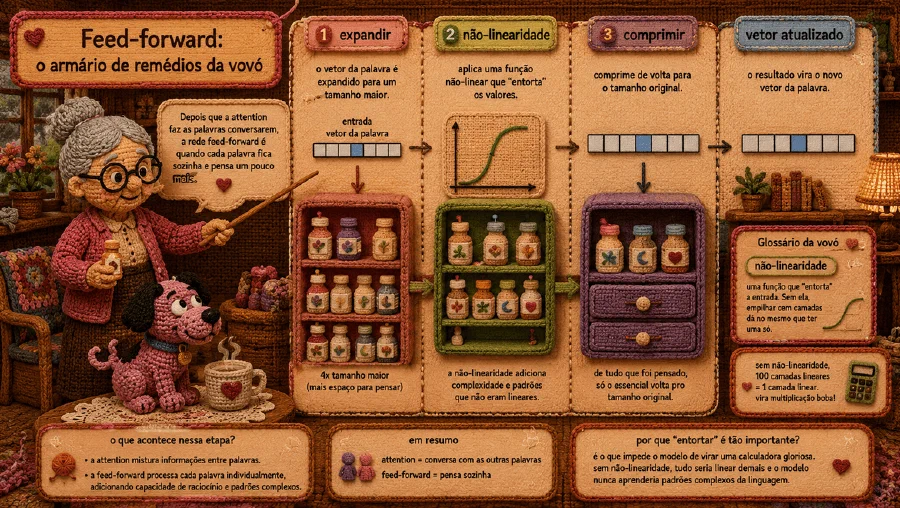
Depois que a attention termina de fazer as palavras conversarem, vem a etapa que ninguém comenta: a rede feed-forward (FFN).
Se a attention é sobre palavras conversando entre si, a FFN é sobre cada palavra, sozinha, pensando mais um pouco. Ela faz três coisas em ordem: expande o vetor pra um tamanho maior, aplica uma função não-linear e comprime de volta.
Glossário da vovó - não-linearidade: uma função que “entorta” a entrada. Sem ela, empilhar cem camadas dá no mesmo que ter uma só - vira tudo uma multiplicação boba.
Essa parte do entortar é o que impede o modelo de virar uma calculadora gloriosa. Sem ela, duas camadas lineares em sequência são matematicamente iguais a uma só, e cem camadas continuam valendo por uma. A não-linearidade é o que salva a brincadeira.
Aqui mora a parte mais surpreendente: a maioria dos parâmetros de um modelo está na FFN, não na attention. E esses parâmetros não são genéricos - é onde boa parte do conhecimento do modelo fica guardado. Pesquisadores acharam neurônios que disparam forte em texto sobre a Torre Eiffel, outros em linguagens de programação, outros em verbos no passado. Quando o modelo “sabe” que Paris é a capital da França, esse fato está espalhado pelos pesos da FFN.
É o armário de remédios da sua avó. Cada coisa tem sua gaveta, ela sabe exatamente onde está o que - e que Deus (ou Shiva) te ajude se você mexer na ordem.
O detalhe digno de filme de ficção: dá pra editar fatos direto no modelo sem treinar de novo. Métodos como o ROME conseguem trocar “a Torre Eiffel fica em Paris” por “a Torre Eiffel fica em Roma” mexendo cirurgicamente numa matriz específica. É uma lobotomia de precisão. O modelo passa a jurar que a Torre é italiana e dorme tranquilo.
E os modelos mais novos começaram a trocar a FFN única por uma Mistura de Especialistas (MoE): em vez de uma rede, várias redes paralelas (os “especialistas”) e um roteadorzinho que escolhe quais processam cada palavra. O Mixtral 8x7B tem 8 especialistas por camada, mas só ativa 2 por token. É a vovó delegando: pergunta de bolo vai pra tia que cozinha, pergunta de pressão alta vai pra tia enfermeira. Não precisa acordar a família inteira pra cada dúvida.
Glossário da vovó - MoE: o modelo tem vários especialistas e manda cada palavra só pra alguns deles. Cresce o tamanho sem explodir o custo.
Residual stream e Next token: a panela que nunca recomeça do zero e o adivinhão
Esse aqui é o encanamento sem glamour que segura tudo de pé.
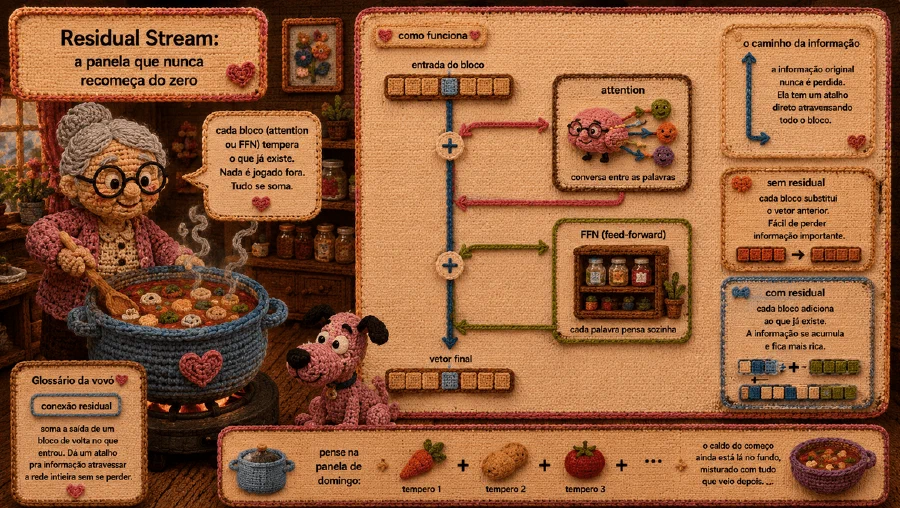
O residual stream é o que torna o modelo “aditivo” em vez de “substitutivo”. Quando a attention roda, ou quando a FFN roda, o resultado geralmente não substitui o vetor da palavra - ele é somado a ele. Vetor novo = vetor velho + o que o bloco produziu.
Glossário da vovó - conexão residual: soma a saída de um bloco de volta no que entrou. Dá um atalho pra informação atravessar a rede inteira sem se perder.
Ao longo de trinta, cinquenta, cem camadas, cada contribuição se acumula em vez de apagar a anterior. É a panela de domingo: você não joga a sopa fora e recomeça a cada tempero novo. Vai adicionando, provando, ajustando. O caldo do começo ainda está lá no fundo, misturado com tudo que veio depois.
Esse truque nem nasceu pra transformer - veio da ResNet (HE et al., 2015), feita pra reconhecimento de imagem. O problema era que redes muito profundas eram impossíveis de treinar: o sinal de aprendizado chegava fraco demais lá atrás. O atalho resolveu, e de repente deu pra treinar redes com centenas de camadas.
A segunda peça é a normalização de camada (layer norm), que existe por um motivo bem prático: sem ela, os números do residual stream ou explodem pro infinito ou desabam pra zero ao longo de tantas somas. A layer norm reescala o vetor pra uma faixa controlada entre os blocos. É a vovó abaixando o fogo pra sopa não transbordar nem esfriar. Os modelos modernos usam uma versão mais barata chamada RMSNorm, que faz quase a mesma coisa gastando menos.
Sem conexão residual, modelo profundo não treina. Sem normalização, o caldo transborda. Com os dois, você empilha cem camadas e dorme tranquilo.
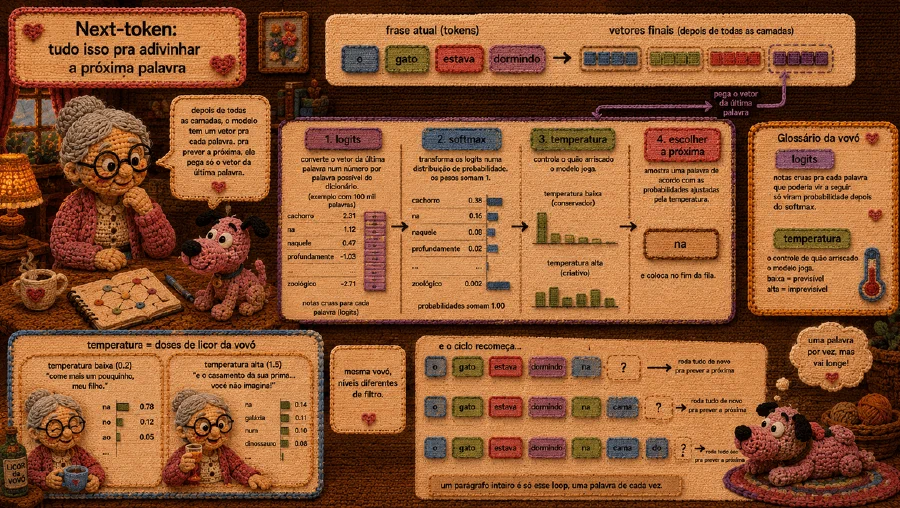
Depois de todas as camadas, o modelo tem um vetor pra cada palavra. Pra prever a próxima, ele pega só o vetor da última palavra e converte num número por palavra possível do dicionário. Se o dicionário tem 100 mil palavras, são 100 mil números. Esses números crus se chamam logits.
Glossário da vovó - logits: notas cruas pra cada palavra que poderia vir a seguir. Só viram probabilidade depois do softmax.
O softmax (de novo ele) transforma esses logits numa distribuição de probabilidade. E aí o modelo não escolhe sempre a palavra mais provável - senão seria um chato previsível. Quem controla isso é a temperatura: baixa deixa o modelo conservador, alta deixa ele criativo (e muitas vezes doidão).
Glossário da vovó - temperatura: o controle de quão arriscado o modelo joga. Baixa = previsível, alta = imprevisível.
A temperatura é quantas doses de licor a vovó tomou no almoço. Temperatura zero: “come mais um pouquinho, meu filho”. Temperatura alta: ela solta cada verdade sobre o casamento da sua prima que a mesa inteira fica em silêncio. Mesma vovó, níveis diferentes de filtro.
Escolhida a palavra, ela entra na fila e o modelo roda tudo de novo pra próxima. E de novo. E de novo. Um parágrafo inteiro é só esse loop, uma palavra de cada vez.
E olha o ponto que confunde todo mundo: o modelo-base não é treinado pra falar verdade, nem pra raciocinar, nem pra ser simpático. Ele é treinado pra adivinhar a próxima palavra num oceano de texto. Por isso ele às vezes inventa com a maior cara de pau - é a vovó contando a história do seu parto, que muda de detalhe toda vez mas é narrada sempre com a mesma convicção. Simpatia, segurança e bom comportamento vêm depois, num ajuste fino chamado pós-treino.
Ah, e tem um truque de velocidade esperto chamado speculative decoding: um modelo pequeno e rápido chuta as próximas palavras, e o grande só confere se aceita. É a netinha adolescente puxa-saco completando as frases da vovó, e a vovó só balançando a cabeça que sim.
No fundo, é tudo o mesmo esqueleto
A essa altura a pergunta óbvia é: então qual a diferença entre GPT, Claude, Gemini e LLaMA? Os detalhes fechados a gente não conhece todos, mas no nível que vimos aqui, eles moram todos no mesmo bairro arquitetônico.
Todos usam a mesma estrutura: tokenização, embeddings, posição, camadas de attention e feed-forward empilhadas, residual stream, normalização e o loop de next-token. O que muda de um pro outro é basicamente: os pesos treinados (dados diferentes, escalas diferentes), a configuração (número de camadas, tamanho do dicionário, MoE ou denso) e o pós-treino (ajuste de instrução, feedback humano, controles de segurança).
Glossário da vovó - pesos: os números aprendidos dentro do modelo. O treino fica mexendo neles até o modelo acertar o texto direito.
O mais curioso é que o “transformer moderno” de 2023 a 2025 convergiu pra um conjunto parecido de escolhas - pre-norm, RMSNorm, RoPE, SwiGLU, GQA, MoE nos maiores - mesmo com times diferentes chegando lá por conta própria. Nenhuma dessas peças foi inventada de uma vez. Foram cinco anos lapidando o design original de 2017.
E pode mudar. Os state-space models tipo Mamba são alternativas sérias pra textos muito longos. Arquiteturas híbridas estão sendo testadas. Mas os mecanismos básicos que a gente viu - virar texto em número, dar significado, marcar posição, deixar as palavras se olharem, processar cada uma, somar tudo num caldo e adivinhar a próxima - são a parte durável. Qualquer modelo de sequência vai ter que resolver esses mesmos problemas de algum jeito.
No fim, toda a “inteligência artificial” que assombra sua avó é isto: um dicionário de pedacinhos, um mapa de significados, um monte de continha de matriz e uma vontade obstinada de adivinhar a próxima palavra. A resposta pra vida, o universo e tudo mais talvez seja 42, mas a resposta pra “como essa coisa funciona” é, decepcionantemente, “muita multiplicação”.
Sua avó vai continuar achando que tem gente presa no celular. E, honestamente, depois de explicar tudo isso, eu mesmo não tenho mais tanta certeza de que ela está errada.
Referências
HE, Kaiming et al. Deep residual learning for image recognition. [S. l.]: arXiv, 2015. arXiv:1512.03385. Publicado em: IEEE Conference on Computer Vision and Pattern Recognition (CVPR), 2016. p. 770-778.
LIU, Nelson F. et al. Lost in the middle: how language models use long contexts. [S. l.]: arXiv, 2023. arXiv:2307.03172. Publicado em: Transactions of the Association for Computational Linguistics (TACL), v. 12, p. 157-173, 2024.
OLSSON, Catherine et al. In-context learning and induction heads. Transformer Circuits Thread, 2022. arXiv:2209.11895. Disponível em: https://transformer-circuits.pub/2022/in-context-learning-and-induction-heads/ . Acesso em: 8 jun. 2026.
SU, Jianlin et al. RoFormer: enhanced transformer with rotary position embedding. [S. l.]: arXiv, 2021. arXiv:2104.09864. Publicado em: Neurocomputing, v. 568, art. 127063, 2024.
VASWANI, Ashish et al. Attention is all you need. In: ADVANCES IN NEURAL INFORMATION PROCESSING SYSTEMS (NeurIPS), 30., 2017, Long Beach. Anais […]. [S. l.]: Curran Associates, 2017.
