Explicando LLM para tu abuelita
Tu abuelita probablemente ya habló con una LLM. Pidió una receta de torta al ChatGPT, le preguntó al asistente del celular si iba a llover, y salió de ahí pensando que había una personita minúscula atrapada dentro del aparato —o el diablo, depende de la abuela.
Y lo gracioso es que la mayoría de la gente que usa estas herramientas todos los días no está mucho más enterada que la abuela. Saben que funciona. No tienen idea de cómo. Es solo una caja negra que escupe texto.
Vamos a abrir la caja. Sin esa matemática que hace derretir el cerebro, y con analogías que caben en un almuerzo dominical. Si al final logras explicárselo a tu abuela sin que haga la señal de la cruz, misión cumplida.
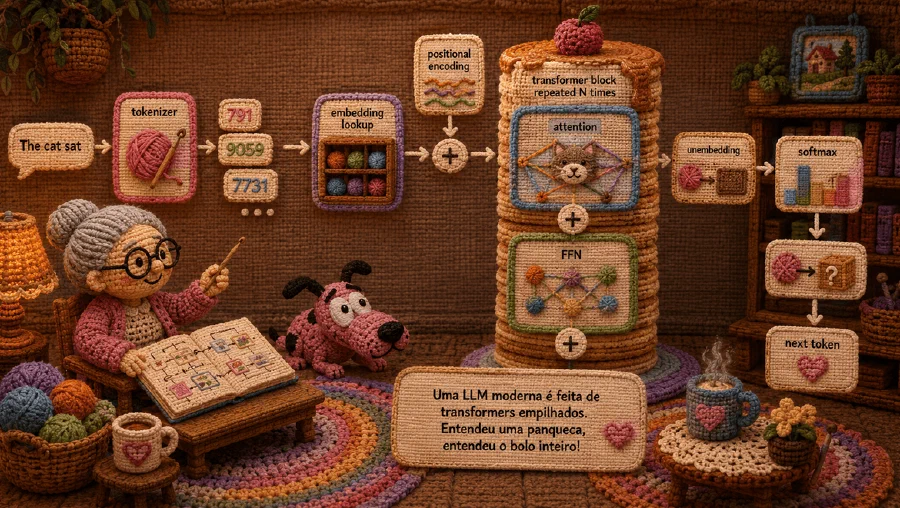
Casi todo lo que vas a leer aquí se resume en una cosa: las LLMs modernas son, en la práctica, bloques llamados transformers apilados uno sobre otro como panqueques. Entendiste un panqueque, entendiste el pastel entero.
Tokens: la abuela no lee la palabra entera
Primera verdad incómoda: el modelo no lee texto. Lee números enteros.
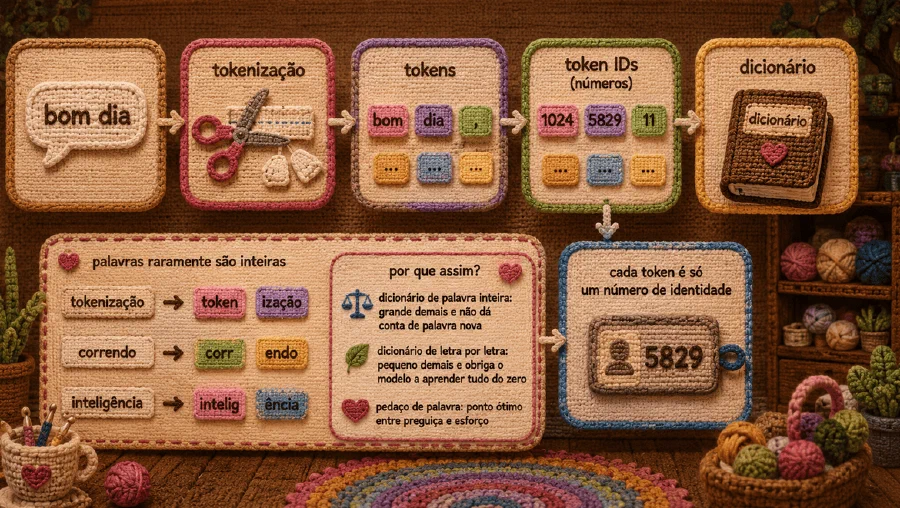
Cuando envías “bom dia”, una etapa llamada tokenización toma esa cadena y la rompe en pedacitos; cada pedacito se convierte en un número (un token ID) que apunta a una entrada en un diccionario fijo. Ese diccionario suele tener desde decenas de miles hasta algunos cientos de miles de pedazos.
Glosario de la abuela - token: es el pedacito de texto que el modelo ve. Y para él, ese pedacito es solo un número de identidad, no la palabra escrita.
El detalle pícaro es que los tokens rara vez son palabras completas. Generalmente son trozos de palabra. “Tokenização” puede volverse [“token”, “ização”]. “Correndo” puede volverse [“corr”, “endo”]. Es la abuela cortando el pan: en rebanadas del tamaño que se puede masticar.
¿Por qué así? Porque un diccionario de palabras enteras sería demasiado grande y no aguantaría palabras nuevas. Un diccionario letra por letra sería demasiado pequeño y obligaría al modelo a aprender todo desde cero. El trozo de palabra queda en el término medio, el punto óptimo entre pereza y esfuerzo, que es donde a todos nos gustaría vivir.
Y aquí reside la razón de un truco que se hizo viral: pregúntale a una LLM cuántas R hay en “arroz”. Durante mucho tiempo fallaban estrepitosamente. No es que el modelo sea tonto para contar —es que nunca vio las letras a-r-r-o-z. Vio el token “arroz” como un bloque entero. Pedirle que cuente las letras es como pedirte que cuentes los granos del plato sin dejarte mirar dentro de la olla.
Ahora tenemos una fila de números. Pero un número solo no significa nada. Necesitamos darles sentido.
Embeddings: el mapa mental de la abuela
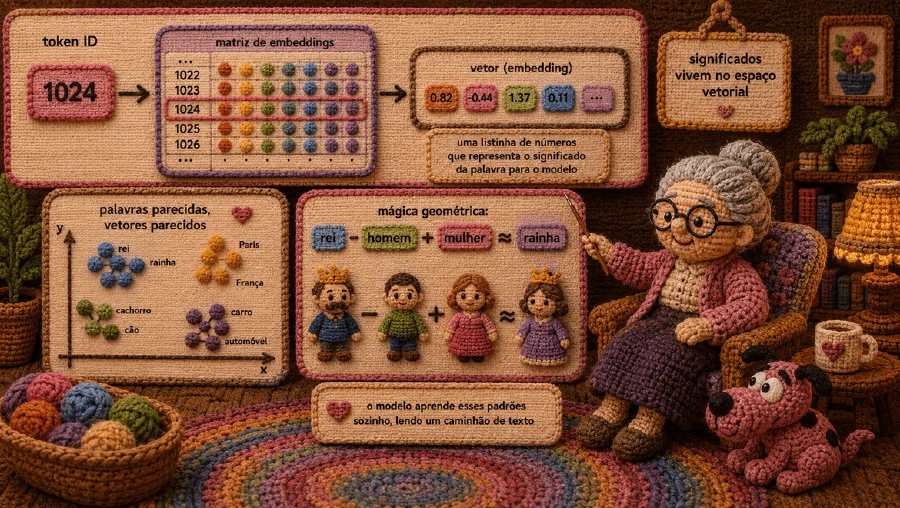
Un token ID tipo 1024 es solo un índice. Es el número de la casa, no la casa. Quien le da significado es una tabla gigante llamada matriz de embeddings.
Funciona así: cada palabra del diccionario tiene una fila en esa tabla, y cada fila es una larga lista de números —un vector. Cuando el tokenizador entrega el número, el modelo va y lo sustituye por el vector correspondiente. Ese vector es lo que el modelo entiende como el “significado” de esa palabra, y lo aprendió solo, leyendo un montón de texto.
Glosario de la abuela - vector: una lista pequeña de números. En el transformer, cada palabra se convierte en una de esas listas para que el modelo pueda hacer cuentas con ella.
Lo interesante es que palabras similares terminan con vectores parecidos. “Rei” queda cerca de “rainha”. “Paris” queda pegado a “França”. Nadie programó eso a mano —surge solo durante el entrenamiento, porque estar cerca ayuda al modelo a acertar el texto.
Es el mapa mental de tu abuela. En su cerebro, “novela” está pegado a “Globo”, que está pegado a “chisme”, que está a dos cuadras de “vecina metiche que se queda con la silla en la vereda todo el día”. Ella nunca dibujó ese mapa. Se fue formando con los años.
Y hay una magia geométrica que da miedo: se pueden hacer cuentas con los vectores. El ejemplo clásico es rei - homem + mulher ≈ rainha. Intenta hacer esa resta en la cabeza de tu abuela y te preguntará si estás comiendo bien.
Pero hay un agujero aquí. El vector de “perro” es el mismo vector ya sea que “perro” sea la primera palabra de la frase o la quinta. El significado está ahí, pero el orden desapareció. Y el orden importa.
Posición y Attention: quién mordió a quién en el almuerzo dominical
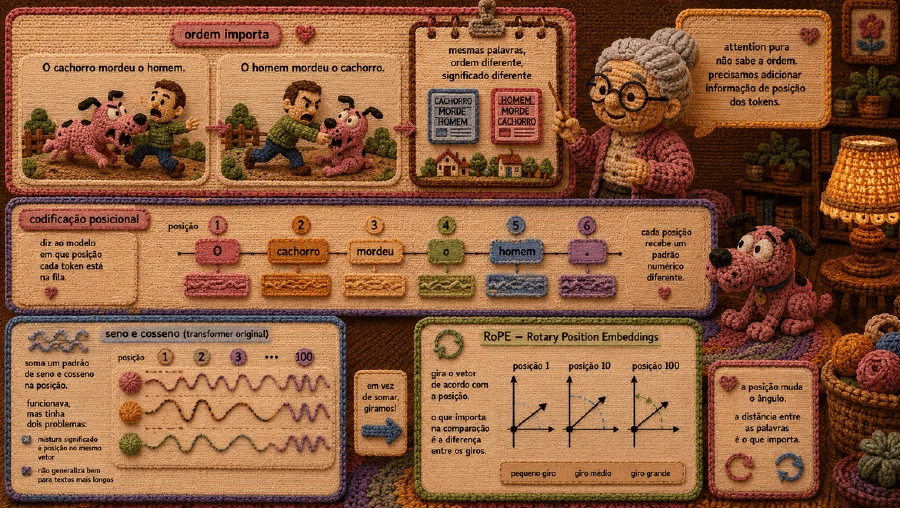
“El perro mordió al hombre” y “El hombre mordió al perro” usan exactamente las mismas palabras. Solo cambia el orden. Y cambia todo —incluida la portada del diario y el nivel de alarma del barrio.
La attention pura (ya llego a ella) no tiene noción de orden incorporada. Así que el modelo necesita una pieza extra que inyecte la posición de cada token en la cuenta. Esto es la codificación posicional.
Glosario de la abuela - codificación posicional: es como el modelo descubre el orden de las palabras. Le dice en qué lugar de la fila está sentado cada token.
El paper original del transformer (VASWANI et al., 2017) hacía esto sumando un patrón de números a la posición de cada palabra —posición 1 tenía un patrón, posición 100 otro, todo basado en ondas de seno y coseno. Funcionaba, pero tenía dos problemas molestos: el vector tenía que cargar significado y posición en el mismo paquete, y el esquema no generalizaba bien a textos más largos de lo que había visto en el entrenamiento.
Los modelos modernos (LLaMA, Mistral, Gemma, Qwen y casi toda la tropa) usan un esquema diferente llamado RoPE - Rotary Position Embeddings (SU et al., 2021). En lugar de sumar la posición, gira los vectores. Palabra en la posición 1 recibe un giro pequeño, palabra en la posición 100 recibe un giro mayor. Cuando dos palabras se comparan después, lo que importa es la diferencia entre los giros —o sea, cuán lejos está una de la otra.
Glosario de la abuela - RoPE: en vez de poner una etiqueta de posición en cada palabra, las gira. La diferencia entre los giros cuenta la distancia entre ellas.
Y curiosamente: aun con buen posicionamiento, las LLMs tienen un problema documentado de “perderse en el medio” (LIU et al., 2023). Usan mejor la información del principio y del final de un texto largo que la del medio. Es la abuela contando una historia: recuerda cómo empezó, recuerda el final dramático, pero lo que pasó en el medio se vuelve “ah, y luego hubo unas cosas”. Por eso ese tip de prompt —“pon lo importante al inicio o repítelo al final”— realmente funciona.
Llegamos a la pieza que le dio nombre a todo. Attention. Atención.
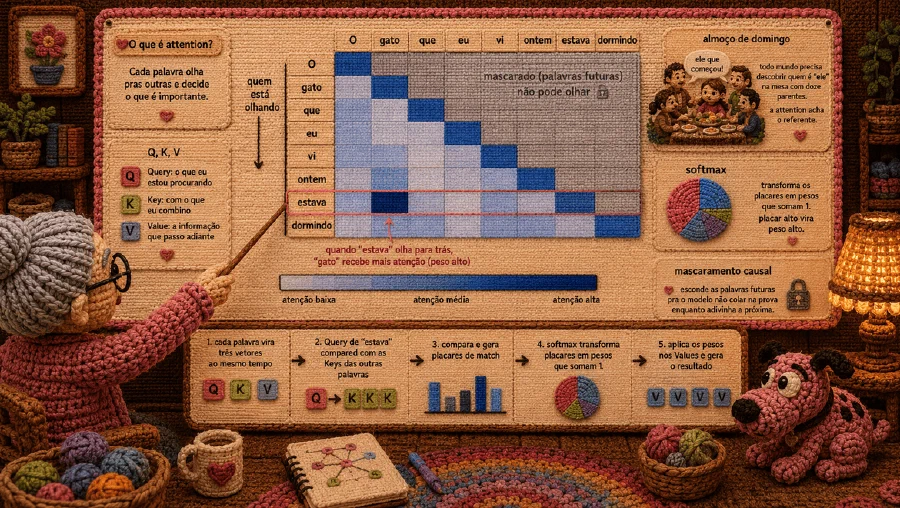
Dentro de cada capa, la attention hace una sola cosa: deja que cada palabra mire a las otras palabras que tiene permiso de ver y decida cuáles importan.
Para eso, cada palabra recibe tres papeles al mismo tiempo, transformándose en tres vectores: Query, Key y Value (Q, K, V).
Glosario de la abuela - Q, K, V: Query es “lo que estoy buscando”, Key es “con qué encajo” y Value es “la información que se copia cuando el encaje es fuerte”.
La palabra “Query” pregunta: “¿qué busco en las otras?”. La “Key” responde: “esto es lo que ofrezco a quien me mire”. Y la “Value” carga: “esto es lo que pasa adelante cuando hay coincidencia”. La misma palabra hace los tres papeles a la vez, igual que tu tía que en el almuerzo pregunta, responde y además pasa el recado a la cocina.
Toma la frase “El gato que vi ayer estaba durmiendo”. Cuando el modelo procesa “estaba”, necesita descubrir qué estaba durmiendo. La Query de “estaba” se compara con las Keys de las otras palabras. La coincidencia con “gato” es alta (el verbo necesita sujeto), la coincidencia con “ayer” es baja. Entonces entra el softmax, que transforma esas puntuaciones en pesos que suman 1, y “gato” recibe el peso gordo.
Glosario de la abuela - softmax: convierte puntuaciones crudas en pesos que suman 1. Puntuación alta se vuelve peso alto, puntuación baja se vuelve peso bajo. Es la abuela decidiendo a quién escuchar en la mesa.
Es literalmente como el almuerzo familiar donde alguien suelta “fue él quien empezó” y todos tienen que averiguar quién es “él” en una mesa de doce parientes. La attention es el tío que mira atrás en la conversación, encuentra el referente y resuelve la bronca después de hacer chiste del chipa.
Hay una regla específica para los modelos estilo GPT: generan texto de izquierda a derecha, así que una palabra en la posición 5 solo puede mirar las posiciones 1 a 5. No puede espiar las 6, 7, 8 —aún no existen. Esto se llama mascaramiento causal. Tu abuela no puede comentar el chisme que todavía no pasó (aunque lo quiera).
Glosario de la abuela - mascaramiento causal: oculta las palabras futuras para que el modelo no copie en el examen mientras adivina la siguiente.
Un hallazgo fascinante de investigación: existen cabezas de attention especializadas llamadas induction heads, descubiertas por un equipo de Anthropic (OLSSON et al., 2022). Aprenden a notar patrones tipo “A B … A” y predecir que viene “B” otra vez. Es uno de los mecanismos más claros detrás del in-context learning —la capacidad de la LLM de tomar un patrón del prompt y continuarlo.
El cálculo de la attention tiene un costo feo: cada palabra se compara con todas las otras, así que doblar el tamaño del texto casi cuadruplica el trabajo. Por eso un prompt gigante sale caro y hay montones de gente investigando cómo hacerlo más eficiente.
Multi-head: la abuela viendo tres novelas a la vez
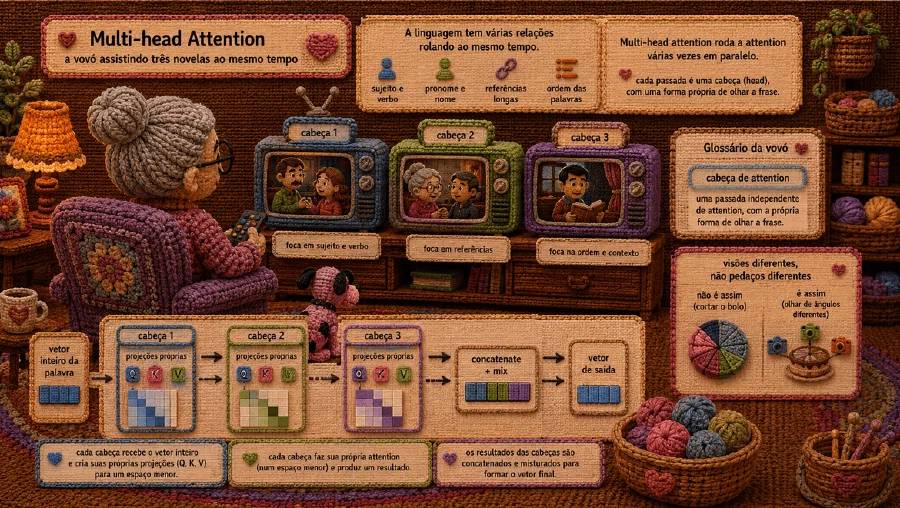
Una sola pasada de attention da una única visión de qué palabras importan. No basta. El lenguaje tiene varias relaciones ocurriendo al mismo tiempo: sujeto y verbo, pronombre y nombre, referencias entre frases distantes, orden de las palabras.
La multi-head attention lo soluciona ejecutando la attention varias veces en paralelo, cada pasada en un espacio más pequeño. Cada pasada de estas es una cabeza (head).
Glosario de la abuela - cabeza de attention: una pasada independiente de attention, con su propia forma de mirar la frase.
Y aquí hay un detalle que la mitad de los tutoriales explica mal: cada cabeza no recibe un trozo cortado del vector original. Cada una tiene sus propias matrices que proyectan el vector entero a un espacio más pequeño. Son vistas diferentes de la misma palabra, no pedazos distintos de ella. Es la diferencia entre cortar el pastel en porciones y sacarle ocho fotos al pastel entero desde ángulos distintos.
Es la abuela siguiendo tres novelas, un partido y un chisme de WhatsApp al mismo tiempo —cada “cabeza” rastrea una trama: esta solo mira quién engaña a quién, aquella solo al hijo perdido, la otra a la herencia. Nadie le dijo que se especializara así. Ocurrió con los años.
El modelo tampoco recibe instrucciones sobre qué debe hacer cada cabeza. La especialización emerge en el entrenamiento. Los investigadores han encontrado cabezas que rastrean gramática, cabezas que enlazan pronombres con nombres, cabezas de posición, las llamadas induction heads. Una capa puede tener 32 cabezas. Un modelo puntero tiene decenas de capas. Resultado: miles de cabezas, cada una con su maña.
Hay un costo aquí también. Cada cabeza necesita guardar sus Keys y Values en memoria para no recalcular todo cada vez que aparece una palabra nueva —eso es el KV cache, el principal gasto de memoria al ejecutar una LLM en texto largo. Para ahorrar, los modelos modernos usan una variación llamada GQA (Grouped-Query Attention), donde grupos de cabezas comparten las mismas Keys y Values. LLaMA-2 70B tiene 64 cabezas de Query pero solo 8 de Key/Value. Casi la misma precisión, mucho menos peso.
Feed-forward: el botiquín de la abuela
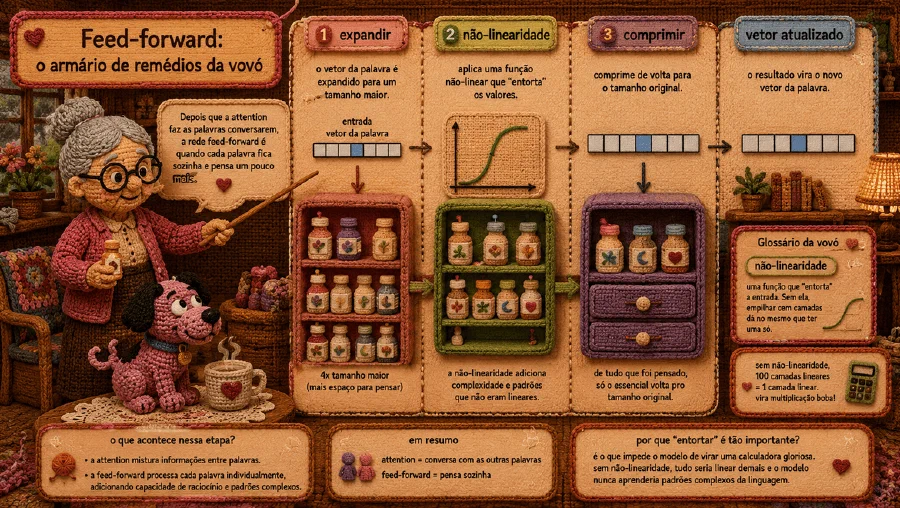
Después de que la attention deja que las palabras conversen, viene la etapa que nadie comenta: la red feed-forward (FFN).
Si la attention es sobre palabras conversando entre sí, la FFN es sobre cada palabra, sola, pensando un poco más. Hace tres cosas en orden: expande el vector a un tamaño mayor, aplica una función no lineal y lo comprime de nuevo.
Glosario de la abuela - no linealidad: una función que “dobla” la entrada. Sin ella, apilar cien capas sería igual que tener una sola —todo se convertiría en una multiplicación tonta.
Esa parte del doblado es lo que evita que el modelo sea una calculadora glorificada. Sin ella, dos capas lineales en secuencia son matemáticamente iguales a una sola, y cien capas seguirían valiendo por una. La no linealidad salva el juego.
Aquí está la parte más sorprendente: la mayoría de los parámetros de un modelo están en la FFN, no en la attention. Y esos parámetros no son genéricos —es donde buena parte del conocimiento del modelo está guardado. Investigadores han hallado neuronas que disparan fuerte con texto sobre la Torre Eiffel, otras con lenguajes de programación, otras con verbos en pasado. Cuando el modelo “sabe” que París es la capital de Francia, ese hecho está repartido por los pesos de la FFN.
Es el botiquín de la abuela. Cada cosa tiene su gaveta, ella sabe exactamente dónde está lo que —y que Dios (o Shiva) te ayude si cambias el orden.
El detalle digno de película de ciencia ficción: se puede editar hechos directamente en el modelo sin volver a entrenarlo. Métodos como ROME logran cambiar “la Torre Eiffel está en París” por “la Torre Eiffel está en Roma” trabajando quirúrgicamente sobre una matriz específica. Es una lobotomía de precisión. El modelo pasa a jurar que la Torre es italiana y duerme tranquilo.
Y los modelos más nuevos empezaron a sustituir la FFN única por una Mixtura de Especialistas (MoE): en vez de una red, varias redes en paralelo (los “especialistas”) y un pequeño enrutador que elige cuáles procesan cada palabra. El Mixtral 8x7B tiene 8 especialistas por capa, pero solo activa 2 por token. Es la abuela delegando: pregunta de torta va a la tía que cocina, pregunta de hipertensión va a la tía enfermera. No hace falta despertar a toda la familia para cada duda.
Glosario de la abuela - MoE: el modelo tiene varios especialistas y manda cada palabra solo a algunos. Crece el tamaño sin explotar el costo.
Residual stream y Next token: la olla que nunca reinicia y el adivinador
Esta es la tubería sin glamour que sostiene todo.
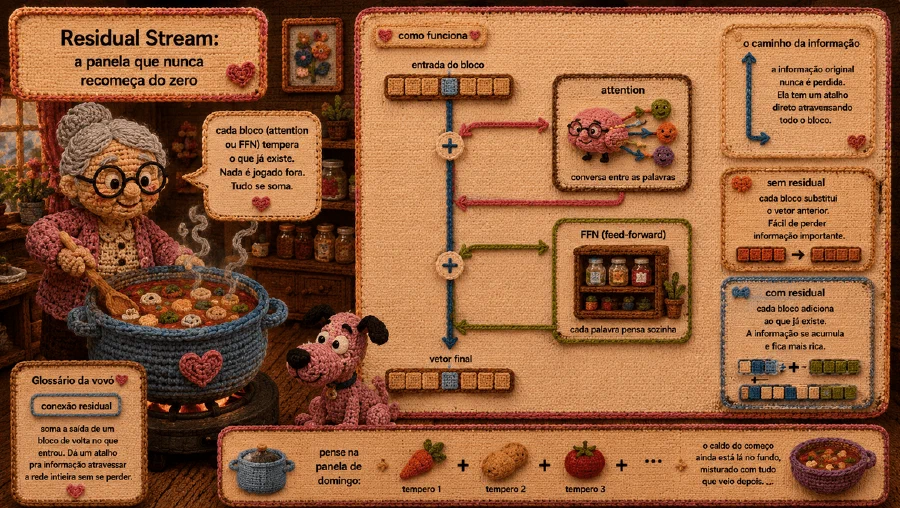
El residual stream es lo que hace al modelo “aditivo” en lugar de “sustitutivo”. Cuando la attention corre, o cuando la FFN corre, el resultado generalmente no sustituye el vector de la palabra —se suma a él. Vector nuevo = vector viejo + lo que produjo el bloque.
Glosario de la abuela - conexión residual: suma la salida de un bloque de vuelta a lo que entró. Da un atajo para que la información atraviese toda la red sin perderse.
A lo largo de treinta, cincuenta, cien capas, cada contribución se acumula en vez de borrar la anterior. Es la olla del domingo: no tiras la sopa y empiezas de nuevo con cada nuevo condimento. Vas añadiendo, probando, ajustando. El caldo del principio sigue ahí al fondo, mezclado con todo lo que vino después.
Este truco no nació en el transformer —viene de ResNet (HE et al., 2015), hecha para reconocimiento de imágenes. El problema era que redes muy profundas eran imposibles de entrenar: la señal de aprendizaje llegaba demasiado débil allá atrás. El atajo resolvió eso, y de repente fue posible entrenar redes con cientos de capas.
La segunda pieza es la normalización de capa (layer norm), que existe por un motivo práctico: sin ella, los números del residual stream o explotan al infinito o se desmoronan a cero a lo largo de tantas sumas. La layer norm reescala el vector a un rango controlado entre bloques. Es la abuela bajando el fuego para que la sopa no se desborde ni se enfríe. Los modelos modernos usan una versión más barata llamada RMSNorm, que hace casi lo mismo gastando menos.
Sin conexión residual, el modelo profundo no se entrena. Sin normalización, el caldo se desborda. Con las dos, apilas cien capas y duermes tranquilo.
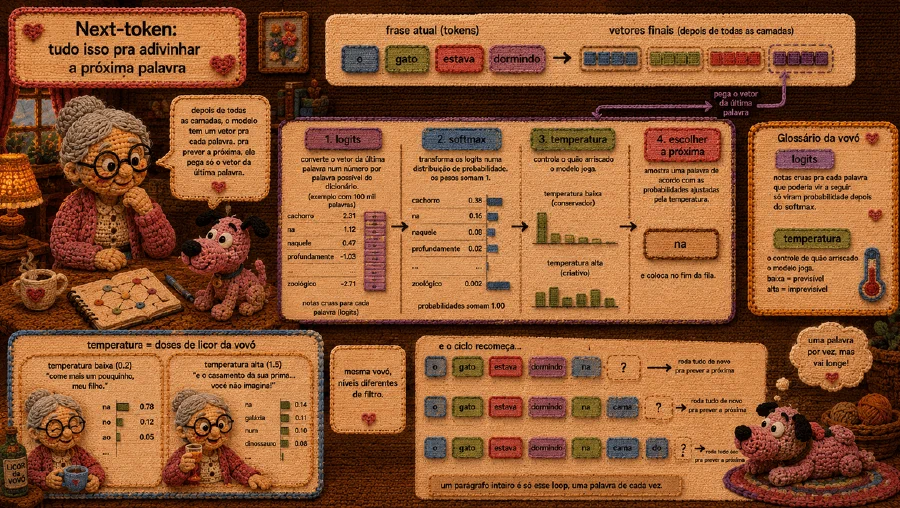
Después de todas las capas, el modelo tiene un vector por cada palabra. Para predecir la siguiente, toma solo el vector de la última palabra y lo convierte en un número por cada palabra posible del diccionario. Si el diccionario tiene 100 mil palabras, son 100 mil números. Esos números crudos se llaman logits.
Glosario de la abuela - logits: notas crudas para cada palabra que podría venir a continuación. Solo se vuelven probabilidades después del softmax.
El softmax (otra vez él) transforma esos logits en una distribución de probabilidad. Y entonces el modelo no siempre elige la palabra más probable —si no sería un aburrido previsible. Quién controla eso es la temperatura: baja lo deja conservador, alta lo vuelve creativo (y muchas veces descontrolado).
Glosario de la abuela - temperatura: el control de cuán arriesgado juega el modelo. Baja = predecible, alta = impredecible.
La temperatura es cuántas copitas de licor se tomó la abuela en el almuerzo. Temperatura cero: “come un poco más, hijo”. Temperatura alta: suelta cada verdad sobre el matrimonio de tu prima y toda la mesa queda en silencio. Misma abuela, diferentes filtros.
Elegida la palabra, entra en la fila y el modelo corre todo de nuevo para la siguiente. Y otra vez. Y otra vez. Un párrafo entero no es más que este bucle, una palabra a la vez.
Y aquí está el punto que confunde a todos: el modelo-base no se entrena para decir verdad, ni para razonar, ni para ser simpático. Se entrena para adivinar la siguiente palabra en un océano de texto. Por eso a veces inventa con mucha cara de piedra —es la abuela contando la historia de tu nacimiento, que cambia de detalle cada vez pero se narra siempre con la misma convicción. Simpatía, seguridad y buen comportamiento vienen después, en un ajuste fino llamado pos-entrenamiento.
Ah, y hay un truco de velocidad ingenioso llamado speculative decoding: un modelo pequeño y rápido patea las próximas palabras, y el grande solo verifica si las acepta. Es la nieta adolescente aduladora completando las frases de la abuela, y la abuela solo moviendo la cabeza en señal de “sí”.
Al fondo, todo es el mismo esqueleto
A estas alturas la pregunta obvia es: entonces, ¿cuál es la diferencia entre GPT, Claude, Gemini y LLaMA? Los detalles cerrados no los conocemos todos, pero al nivel que vimos aquí, todos viven en el mismo barrio arquitectónico.
Todos usan la misma estructura: tokenización, embeddings, posición, capas de attention y feed-forward apiladas, residual stream, normalización y el bucle de next-token. Lo que cambia de uno a otro es básicamente: los pesos entrenados (datos distintos, escalas distintas), la configuración (número de capas, tamaño del diccionario, MoE o denso) y el pos-entrenamiento (ajuste por instrucciones, feedback humano, controles de seguridad).
Glosario de la abuela - pesos: los números aprendidos dentro del modelo. El entrenamiento los va ajustando hasta que el modelo acierta el texto.
Lo más curioso es que el “transformer moderno” de 2023 a 2025 convergió hacia un conjunto parecido de elecciones —pre-norm, RMSNorm, RoPE, SwiGLU, GQA, MoE en los más grandes— aunque equipos distintos hayan llegado ahí por su cuenta. Ninguna de estas piezas fue inventada de una vez. Fueron cinco años puliendo el diseño original de 2017.
Y puede cambiar. Los state-space models como Mamba son alternativas serias para textos muy largos. Arquitecturas híbridas se están probando. Pero los mecanismos básicos que vimos —convertir texto en números, dar significado, marcar posición, dejar que las palabras se miren, procesar cada una, sumar todo en un caldo y adivinar la siguiente— son la parte duradera. Cualquier modelo de secuencia tendrá que resolver esos mismos problemas de algún modo.
Al final, toda la “inteligencia artificial” que asusta a tu abuela es esto: un diccionario de pedacitos, un mapa de significados, un montón de cuentas con matrices y una voluntad obstinada de adivinar la siguiente palabra. La respuesta a la vida, el universo y todo lo demás quizá sea 42, pero la respuesta a “cómo funciona esta cosa” es, decepcionantemente, “mucha multiplicación”.
Tu abuela seguirá pensando que hay gente atrapada en el celular. Y, honestamente, después de explicarle todo esto, yo mismo ya no estoy tan seguro de que esté equivocada.
Referencias
HE, Kaiming et al. Deep residual learning for image recognition. [S. l.]: arXiv, 2015. arXiv:1512.03385. Publicado em: IEEE Conference on Computer Vision and Pattern Recognition (CVPR), 2016. p. 770-778.
LIU, Nelson F. et al. Lost in the middle: how language models use long contexts. [S. l.]: arXiv, 2023. arXiv:2307.03172. Publicado em: Transactions of the Association for Computational Linguistics (TACL), v. 12, p. 157-173, 2024.
OLSSON, Catherine et al. In-context learning and induction heads. Transformer Circuits Thread, 2022. arXiv:2209.11895. Disponível em: https://transformer-circuits.pub/2022/in-context-learning-and-induction-heads/ . Acesso em: 8 jun. 2026.
SU, Jianlin et al. RoFormer: enhanced transformer with rotary position embedding. [S. l.]: arXiv, 2021. arXiv:2104.09864. Publicado em: Neurocomputing, v. 568, art. 127063, 2024.
VASWANI, Ashish et al. Attention is all you need. In: ADVANCES IN NEURAL INFORMATION PROCESSING SYSTEMS (NeurIPS), 30., 2017, Long Beach. Anais […]. [S. l.]: Curran Associates, 2017.
